
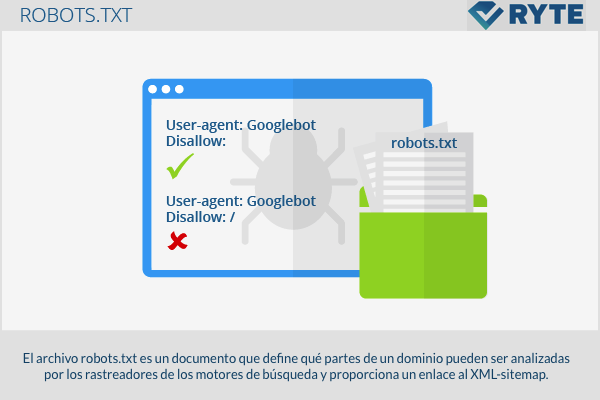
El archivo robots.txt es un documento que establece qué partes de un dominioUn dominio es una sección de Internet con direcciones que comparten un sufijo común o están bajo el control de una organización o individuo en particular. Está organizado jerárquicamente. Tanto los objetos físicos como los virtuales pueden ser direccionados con el nombre de dominio. Estos objetos pueden ser webs, ordenadores en red o servicios, como impresoras, faxes o servidores de correo. Cada objeto está referenciado por una dirección IP única, más pueden ser analizadas por los rastreadores de los motores de búsquedaConcepto de Motores de Búsqueda¿Qué son los Motores de Búsqueda?Los Motores de búsqueda, o Search Engines, son lo que se conoce comúnmente como buscadores. Todos aquellos sistemas informáticos que trabajan buscando todos los archivos almacenados en internet por medio de de arañas o crawlers para elaborar páginas de resultados que sirvan para que los usuarios accedan a webs tras realizar una búsqueda. Son los responsables de que, al buscar cualquier más y proporciona un link al XML-sitemap.
Estructura
El llamado “Robots Exclusion Standard Protocol“, Protocolo Estándar de Exclusiones Robots, se publicó por primera vez en 1994. Este protocolo define que los rastreadores de los motores de búsqueda deben buscar y leer el archivo llamado “robots.txt“ antes de comenzar con la indexaciónGeneralmente, la indexación' se refiere a un método de adquisición de información (desarrollo de información), a través el cual los documentos se recopilan y clasifican en función de palabras clave. Después, se forma un índice que es semejante a una biblioteca. Los documentos indexados, en su mayoría contenido de texto, se preparan para una búsqueda de un documento específico o palabra clave y se les proporcionan descriptores. Si quieres una más. Es por ello que se debe colocar en el directorio raízUn directorio raíz (en inglés root directory), es el directorio del nivel más alto de una jerarquía. Además se conoce como documento raíz. Desde esta raíz todos los demás directorios se ramifican. En el caso de las webs, los archivos más necesarios, como las páginas HTML, se encuentran en el directorio raíz del servidor desde el que se solicitará su visualización mediante del navegador. Los directorios raíz además se usan más del dominio. A pesar de todo, debemos recordar que no todos los rastreadores siguen esta misma regla y por ende, los “robots.txt“ no prometen al 100% protección de acceso y privacidad. Algunos motores de búsqueda aún indexan las páginas bloqueadas y muestran inclusive aquellas sin descripción en los SERPsLa expresión SERPs proviene de las siglas de los términos en inglés Search Engine Result Pages es decir, páginas de resultados de los motores de búsqueda. En las SERPs es donde se encuentran los resultados de búsqueda de los motores de búsqueda y se organizan de mayor a menor relevancia. El posicionamiento lo determinan los motores de búsqueda de acuerdo al análisis de muchos factores y criterios de relevancia y más. Esto sucede concretamente con sitios web que contienen demasiados enlaces. A pesar de todo, los motores de búsqueda más importantes como Google, YahooConcepto de Yahoo¿Qué es Yahoo?Yahoo es una de las principales plataformas que se pueden visitar en internet. Una de las firmas pioneras en materia de buscadores web que, actualmente, ofrece además servicios de email, de noticias y muchas más posibilidades al alcance de cualquiera que ingrese en su web. Es uno de los nombres más reputados y vinculados al fenómeno digital y a la red tal y como la conocemos más y BingBing es el sucesor del motor de búsqueda "Live Search" de Microsoft y se considera una ayuda para la toma de decisiones. Desde su entrada en el mercado en 2009, Bing ha estado tratando de alcanzar a su competidor superior Google, pero no ha sido capaz de ganar una mayor cuota de mercado. Siendo eclipsado por el dominio de Google, el algoritmo de Bing no ha estado recibiendo mucha atención. más sí que se ajustan a las normas del protocolo “robots.txt“.
Creación y control del “robots.txt“
Es simple crear un “robots.txt“ con la ayuda de un editor de textos. Al mismo tiempo, puedes hallar herramientas gratuitas en internet que ofrecen información detallada acerca de cómo generar un archivo “robots.txt“ o que, inclusive, te lo crean automáticamente. Cada archivo contiene 2 bloques. En el primero, se especifica para qué usuarios son válidas las instrucciones. En el segundo bloque se escriben las instrucciones, llamadas “disallowConcepto de Disallow¿Qué es el Disallow?El Disallow, cuya traducción literal es Rechazar, sirve para denegar el acceso a una página o directorio concreto. Se le asocia con el archivo Robots.txt y se le conoce como protocolo de exclusión de robots, el cual impide que los robots de algunos buscadores rastreen contenidos que no pretendemos que indexen en sus resultados. En el punto contrario está el Allow, que permite indicar al más“, con el listado de las páginas que deben excluirse. Se recomienda comprobar con atención que el archivo se haya escrito correctamente antes de descargarlo en el directorio dado que, con básicamente un minúsculo error de sintaxis, se pueden malinterpretar las instrucciones e indexar páginas que, en teoría, no deberían salir en los resultados de búsqueda. Para verificar si el archivo “robots.txt“ funciona correctamente se puede usar la herramienta webmasterEl término webmaster fue utilizado por primera vez por Tim Berners-Lee, el inventor de la World Wide Web, en su documento "Style Guide for Online Hypertext". La palabra se compone de las palabras inglesas "web", forma corta de World Wide Web y "master". En los primeros días de la WWW, a principios de la década de 1990, el término se usaba principalmente como un nombre profesional para las personas que disponen más de Google y realizar un análisis en „status“ -> „blocked URLs“.
Exclusión de páginas
La estructura más simple de un archivo robots.txt aparece del siguiente modo:
User-agent: Googlebot
Disallow:
Este código permite que GooglebotGooglebot es el crawler de Google, que recopila documentos de Internet y los entrega más tarde para la búsqueda de Google. Recopila documentos por medio de de un procedimiento automatizado, que funciona de forma muy parecida a un navegador web. El bot envía una petición y recibe una respuesta de un servidor. Si ciertos parámetros permiten el acceso al Googlebot, éste sube una sola página web, a la que se más analice todas las páginas. Lo contrario, como por ejemplo la prohibición completa del portal web, se escribe del siguiente modo: ‘
User-agent: Googlebot
Disallow:
En la línea del “User-agent“ el usuario escribe para quién va dirigido. Pueden utilizarse los siguientes términos:
- Googlebot (Google search engine)
- Googlebot-Image (Google-image search)
- Adsbot-Google (Google AdWordsCon la finalidad de generar nuevos clientes para una web, existe la oportunidad de colocar anuncios pagados en los resultados de búsqueda, al mismo tiempo de la optimización de los motores de búsqueda (optimización de los componentes técnicos y de contenido de la web). Esto se hace por medio de de programas especiales de pago ofrecidos por los operadores de motores de búsqueda. Google AdWords es un programa de pago más)
- Slurp (Yahoo)
- bingbot (Bing)
Si la orden va dirigida a distintos usuarios cada robot tendrá su línea propia. En mindshape.de vas a poder hallar un resumen de las órdenes y parámetros más comunes para la creación de un robots.txt. Además se puede añadir un link a un XML-Sitemap del siguiente modo:
Sitemap:
http://www.domain.de/sitemap.xm
Ejemplo
# robots.txt for http://www.example.com/

User-agent: UniversalRobot/1.0
User-agent: my-robot
Disallow: /sources/dtd/

User-agent: *
Disallow: /nonsense/
Disallow: /temp/
Disallow: /newsticker.shtml
Relevancia para el SEO ¿Qué es SEO o search engine optimization? Conjunto de prácticas destinadas a mejorar el posicionamiento de una web en el ranking de resultados de los motores de búsqueda. Al contrario que la estrategia SEM, que contempla la inclusión de enlaces contratados para obtener este objetivo, el procedimiento SEO se ocupa exclusivamente de los resultados naturales (no pagados) localizados por el algoritmo propio de cada buscador. Para esto contempla ajustar más
El uso del protocolo robots.txt influye en el acceso de los rastreadores al portal web. Hay dos comandos distintos: «allow» y «disallow». Es muy importante usar correctamente este protocolo dado que si el webmaster bloquea por error – mediante de la orden «disallow» – archivos y contenidos importantes del portal web los rastreadores no serán capaces de leerlo ni indexarlo. A pesar de todo, si se usa correctamente los webmasters son capaces de informar a los rastreadores de cómo repasar la estructura interna de su portal web.
Enlaces web
- Información sobre los archivos robots.txt support.google.com
- Archivo robots.txt: Qué es, para qué sirve y cómo crearlo BlogEl término blog se usa para describir un diario virtual en Internet. El autor de un blogger puede publicar posts sobre cualquier tema. Los posts suelen estar presente de forma cronológica. El estilo de redacción de un blog suele ser informal y se escribe en primera persona. No obstante, además son posibles otros estilos, por ejemplo en el caso de los periódicos online, en los que la atención se centra más ignaciosantiago.com







