Si eres nuevo en la optimización de search enginesConcepto de Motores de Búsqueda¿Qué son los Motores de Búsqueda?Los Motores de búsqueda, o Search Engines, son lo que se conoce comúnmente como buscadores. Todos aquellos sistemas informáticos que trabajan buscando todos los archivos almacenados en internet por medio de de arañas o crawlers para elaborar páginas de resultados que sirvan para que los usuarios accedan a webs tras realizar una búsqueda. Son los responsables de que, al buscar cualquier plus (SEO ¿Qué es SEO o search engine optimization? Conjunto de prácticas destinadas a mejorar el posicionamiento de una web en el ranking de resultados de los motores de búsqueda. Al contrario que la estrategia SEM, que contempla la inclusión de enlaces contratados para obtener este objetivo, el procedimiento SEO se ocupa exclusivamente de los resultados naturales (no pagados) localizados por el algoritmo propio de cada buscador. Para esto contempla ajustar plus) o te encuentras por primera vez con Screaming Frog , This post is for you!
When trying to strike a balance between learning new SEO concepts as a part-time intern and become familiar with the tools we use on a daily basis, notoriously we had less time to interact with the concepts .
Mi primer rastreo como pasante fue para un sitio con más de cientos de miles de UrlEl URL (Localizador Uniforme de Recursos), es una dirección definida que apunta a la posición de un archivo en un servidor y lo recupera. Las URL se introducen en un navegador web para ingresar a documentos en la web o se incrustan como hipervínculos dentro de un documento. Se puede usar un Permalink para que una URL esté disponible de forma permanente. Componentes de una URL • prefijo de protocolo plus y me encontré con un puñado de problemas de los que tuve que aprender. Cuando comience a trabajar en SEO, encontrará herramientas poderosas que lo ayudarán a encontrar datos valiosos. It is important to be able to use and navigate these tools as efficiently as possible.
En R Marketing Digital, una herramienta que usamos a menudo se llama Screaming FrogConcepto de Screaming Frog¿Qué es Screaming Frog?Screaming Frog es una herramienta con la que están familiarizados los profesionales del posicionamiento. Consiste en un software dedicado al SEO que permite repasar una web por completo para detectar qué hace bien y qué hace mal al momento de obtener el mejor posicionamiento factible en buscadores web.Este programa rastrea toda la web como las arañas de los motores de búsqueda para, posteriormente, dar plus, un rastreador de sitios web que rastrea URL y devuelve datos valiosos para que los analicemos para auditar el Technical SEOEl SEO técnico es una parte del SEO, que se centra en las posibilidades de optimización técnica de una web. Éstas incluyen, por ejemplo, el código fuente, los sistemas operativos y las configuraciones de servidor. El SEO técnico nunca es el único responsable de un buen posicionamiento de las palabras clave, sino más bien un prerrequisito para futuras acciones de optimización. Antecedentes Cuando Internet se convirtió en un éxito cada plus y en el sitio.
In this BlogEl término blog se usa para describir un diario virtual en Internet. El autor de un blogger puede publicar posts sobre cualquier tema. Los posts suelen estar presente de forma cronológica. El estilo de redacción de un blog suele ser informal y se escribe en primera persona. No obstante, además son posibles otros estilos, por ejemplo en el caso de los periódicos online, en los que la atención se centra plus, cubriremos cómo configurar su dispositivo para Screaming Frog y las configuraciones que se realizarán para rastrear un sitio y ejecutar su rastreo.
Setting up your device
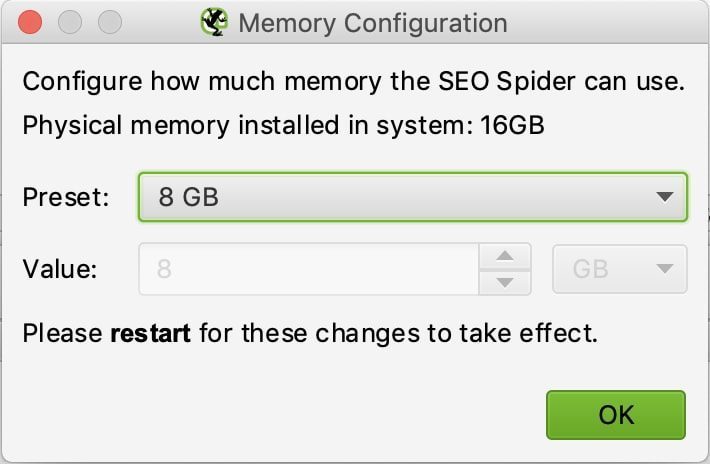
When you start crawling sites, you will find that some sites are larger than others and require more memory from your system to store and process the data that Screaming Frog finds. Before you start crawling websites, it would be beneficial to allocate more RAM from your system to Screaming Frog, allowing for greater speed and flexibility for all future crawls. This will be necessary for sites with more than 150k URLs to crawl.
Settings> System> Memory
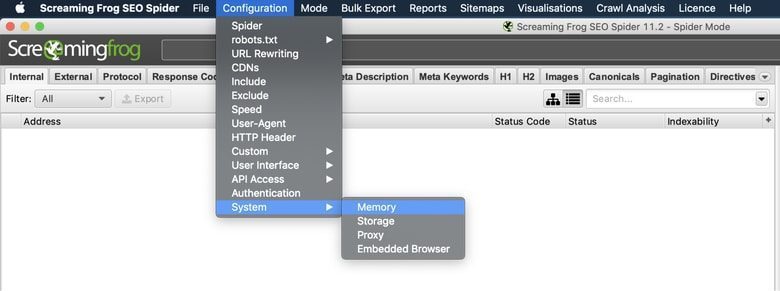
The default settings for 32-bit machines are 1 GB of RAM and 2 GB of RAM for 64-bit machines. I recommend using 8GB, which allows Screaming Frog to crawl up to 5 million URLs. Screaming Frog recommends using 2GB less than your total RAM, but be careful if you dedicate your total RAM, your system may experience a crash.
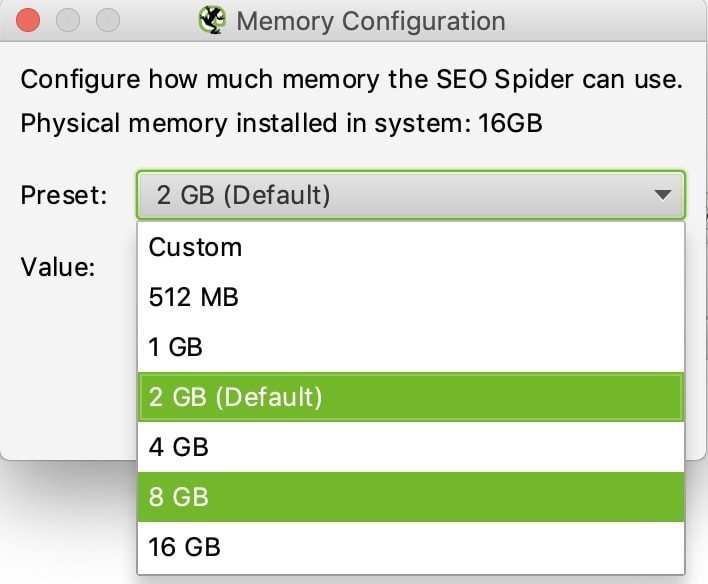
Cuando haya terminado de asignar más RAM a Screaming Frog, deberá reiniciar su softwareConcepto de Software¿Qué es el Software y cuál es su función?Un Software es la parte lógica, o más bien el soporte lógico, de cualquier sistema de tipo informático. Sea un PC, un teléfono teléfono celular o inclusive una tablet, es todo aquel programa que se ejecuta en él gracias a la coordinación de la parte física, es decir, el hardware, para llevar adelante alguna tarea concretamente o un recopilatorio de plus para que se apliquen los cambios.
Configurations
Once you start crawling sites, it is important to adjust your settings accordingly to ensure Screaming Frog is crawling as efficiently as possible. Here I will show you some basic settings that I like to use.
Settings> Spider> Basic
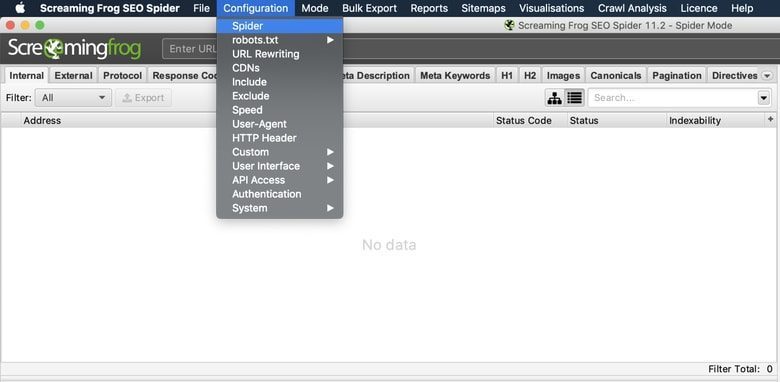
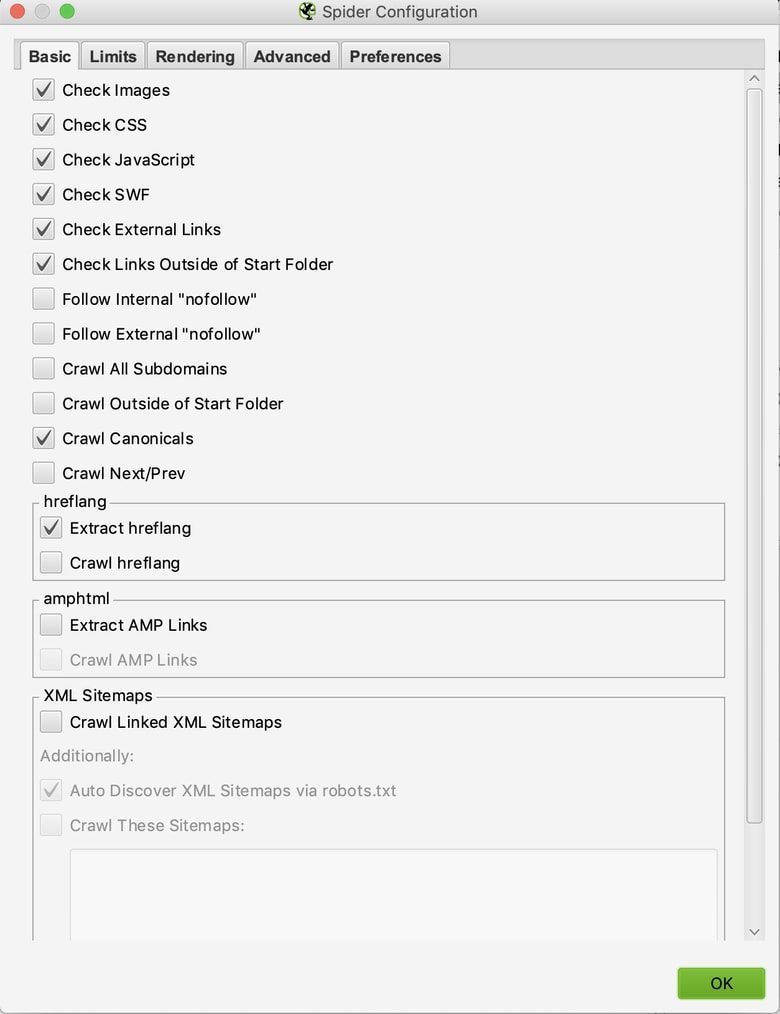
These are the default settings Screaming Frog has for each crawl. It is a good habit to set your specific settings for the trace you are about to run and make adjustments here.
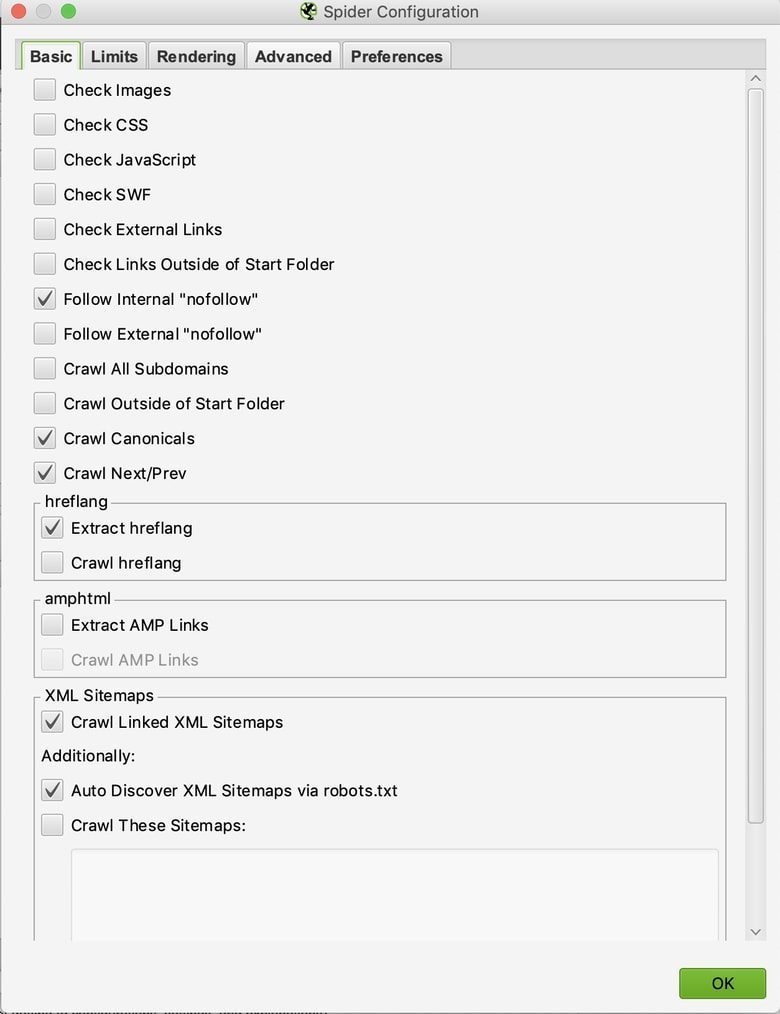
These are the basic settings I use here at R Marketing to run my technical audits:
- Follow " nofollow ”Internal : nos permite rastrear enlaces internosUn link entrante interno apunta a una subpágina dentro de una web, transfiriendo así el poder del link (el llamado "Enlace Juice") a la subpágina. A la vez, los enlaces internos además pasan al PageRank (además llamado flujo de rango de página). Una página obtiene este poder de link de enlaces entrantes externos. Es la página de inicio que tiene el mayor poder de link en la mayoría de los plus con “atributos nofollowEl atributo rel="nofollow" es una microetiqueta en el código HTML de una web. Se usa para etiquetar hipervínculos por lo que no se tiene en cuenta en el índice de Google. Por lo tanto le dice a los robots de los motores de búsqueda que no se les permite seguir los enlaces mientras crawlean o rastrean el sitio. Información general Google introdujo el atributo rel=nofollow- en 2005 y otros motores plus” para verificar si nuestro sitio está implementando esta etiqueta para mostrar contentsEl contenido puede ser muy difícil de definir con precisión. Es una definición que se refiere a las declaraciones contenidas en un documento o publicación de cualquier tipo y puede incluir las tecnologías de la información y la comunicación. Esto cubre todos los tipos de medios como imágenes y texto. A parte de esto, en el campo de la optimización de motores de búsqueda, los términos duplicar contenido, contenido único, plus que queremos / no queremos descubrir o indexar.
- Track Canonicals : allows us to track canonical link elements to verify if we are indicating which pages we want to classify.
- Track next previous : allows us to track rel = "next" and rel = "prev" elements to give us an idea of whether our site clearly communicates the relationship between the pages.
- Extract hreflang : muestra el idioma hreflangHreflang es un atributo que informa a Google y a otros motores de búsqueda sobre las distintos versiones lingüísticas de una página web. El contenido de la web se entregará para que coincida con la región de destino del usuario. La correcta implementación del atributo hreflang puede ser, de esta manera, beneficiosa para la usabilidad e indirectamente beneficiosa para el SEO. Contexto Con la creciente internacionalización de los sitios web, Google introdujo plus, los códigos de región y la URL para verificar que estamos comunicando las diferentes variaciones de nuestro sitio.
- Track site maps XMLEl lenguaje de marcado XML es menos complicado que su nombre ("Extensible Markup Language") puede hacer creer: Un archivo XML contiene texto altamente estructurado, semejante a los archivos HTML. No obstante, la estructuración del texto es tan clara y lógica que puede utilizarse para mapear bases de datos enteras. XML se usa frecuentemente para sitemap que se pueden cargar en la Google Search Console o en las Herramientas para Webmasters plus vinculados : allows us to discover URLs in site maps XML.
- Automatic discovery of XML sitemaps via robots.txt : allows us to find site maps detectables a través de robots.txtEl archivo robots.txt es un documento que establece qué partes de un dominio pueden ser analizadas por los rastreadores de los motores de búsqueda y proporciona un link al XML-sitemap. Estructura El llamado “Robots Exclusion Standard Protocol“, Protocolo Estándar de Exclusiones Robots, se publicó por primera vez en 1994. Este protocolo define que los rastreadores de los motores de búsqueda deben buscar y leer el archivo llamado “robots.txt“ antes de plus
Si está tratando con un sitio que utiliza JavaScriptJavaScript es un lenguaje de programación que funciona en el lado del cliente y con el que las webs pueden ser más funcionales. Incorporación en código HTML El código JavaScript puede ser incrustado en las páginas HTML, para que adquieran funcionalidad. Existen varias opciones. Puede estar entre las etiquetas <SCRIPT> y </SCRIPT>, puede estar contenido en un archivo externo, puede ser un parámetro de las etiquetas HTML, y puede estar plus y desea verificar la navegación interna, deberá ejecutar un rastreo por separado con diferentes configuraciones para esa página específica, no todo el domainUn dominio es una sección de Internet con direcciones que comparten un sufijo común o están bajo el control de una organización o individuo en particular. Está organizado jerárquicamente. Tanto los objetos físicos como los virtuales pueden ser direccionados con el nombre de dominio. Estos objetos pueden ser webs, ordenadores en red o servicios, como impresoras, faxes o servidores de correo. Cada objeto está referenciado por una dirección IP única, plus. Navegue a la pestaña «representación» para asegurarse de que nuestro rastreador pueda encontrar esas instancias.
Settings> Spider> Basic> Rendering
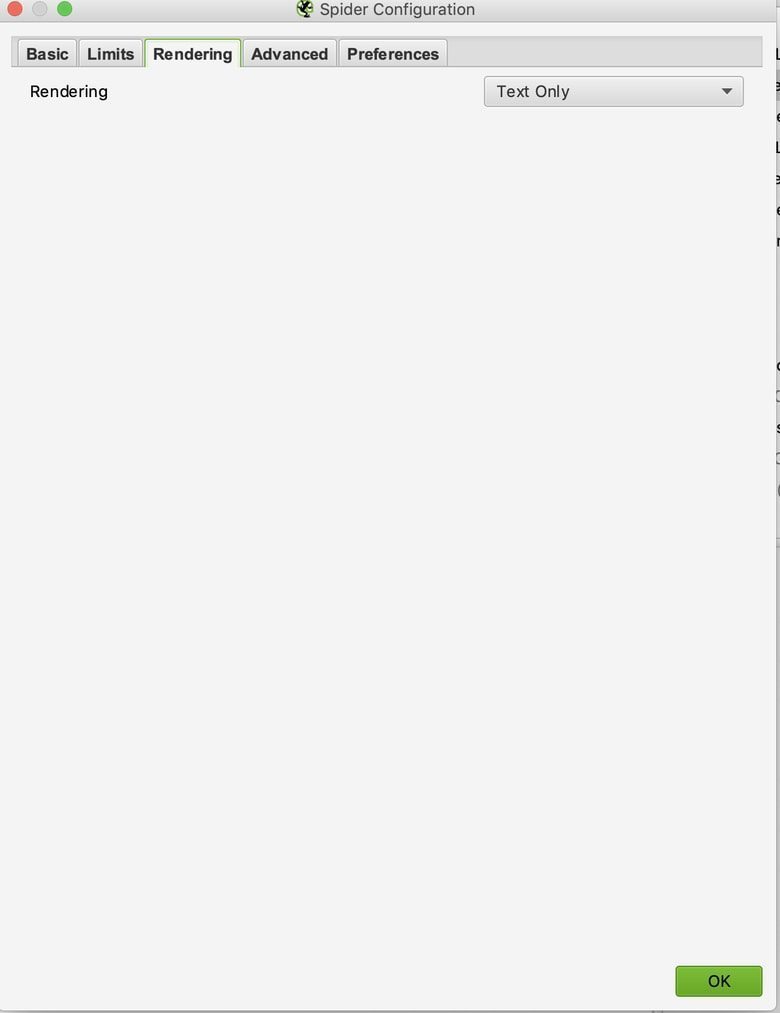
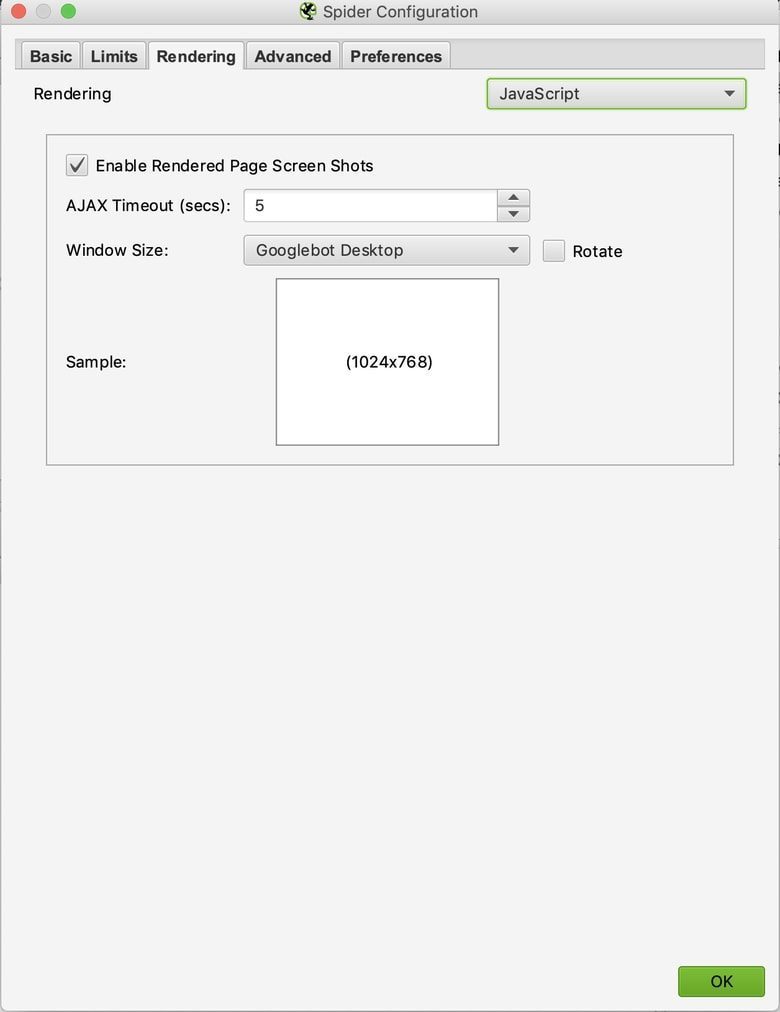
Después de las configuraciones de araña, siempre necesitamos establecer filtersConcepto de Filtros¿Qué son los Filtros?Los Filtros son unos mecanismos que, sea en el campo de la informática o en el de las páginas web, se usan para establecer qué tipo de contenidos se deben visualizar o mostrar por pantalla, o cuáles no deben aparecer. Es algo que se emplea en numerosos lugares con fines muy distintos, pero que siempre tiene como objetivo perfilar la búsqueda para acertar mejor con plus personalizados para cosas específicas que queremos mostrar en nuestro rastreo.
Settings> Custom> Search
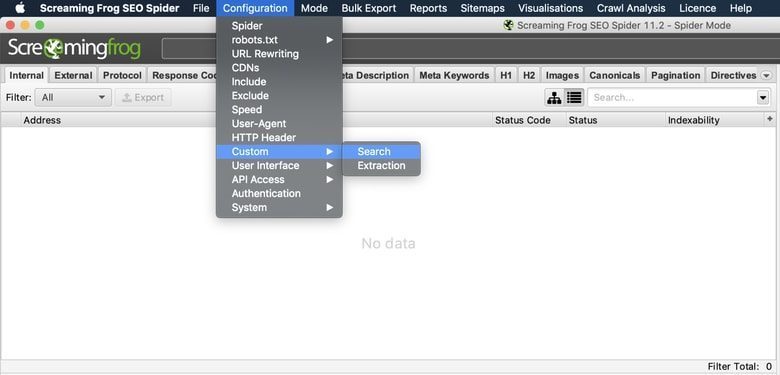
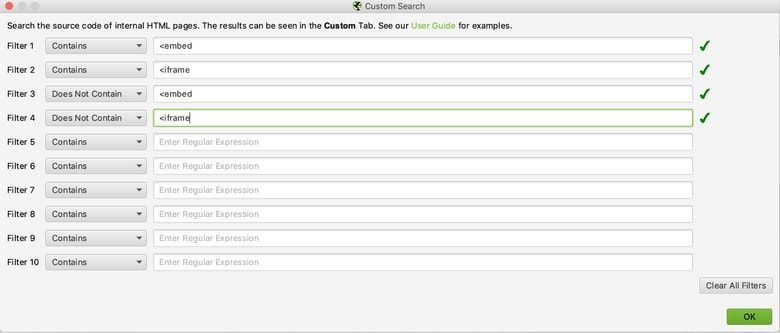
I regularly use these filters to include and exclude things that I want to keep an eye on and to make sure all pages are taken into account:
- <incrustar: comprueba cualquier contenido crucial cargado en flash
- <iframeConcepto de Iframe¿Qué es un Iframe?Un Iframe es un documento de una web que se inserta en otra página web. Consiste en un elemento que puede albergar cualquier tipo de contenido en su interior y que ayuda, entre otras cosas, a ampliar el mensaje que se ofrece con fuentes externas o con material complementario que pueda resultar de interés para el usuario que entra.Este elemento web se usa especialmente al plus: comprueba cualquier contenido cargado en iframe
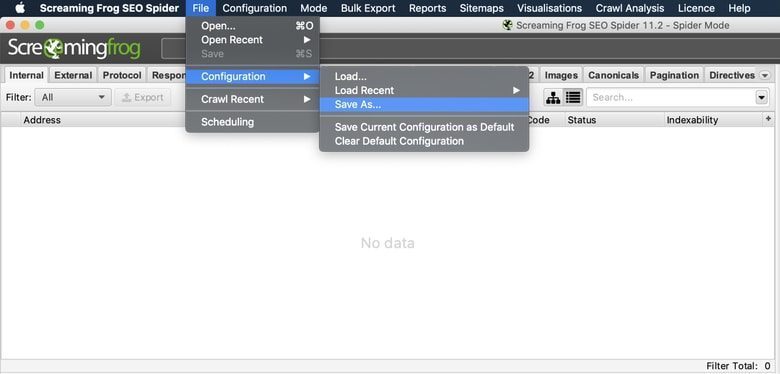
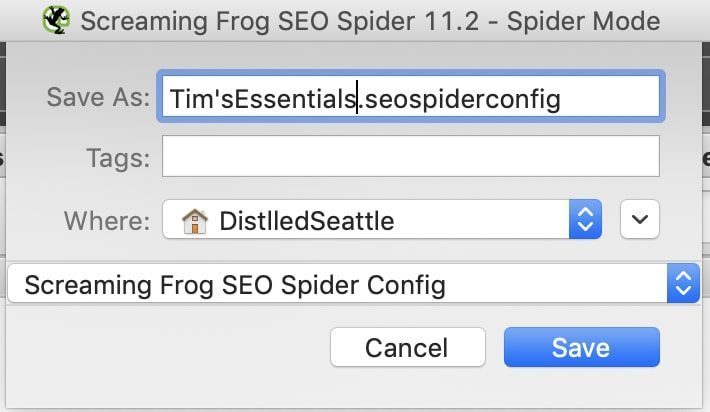
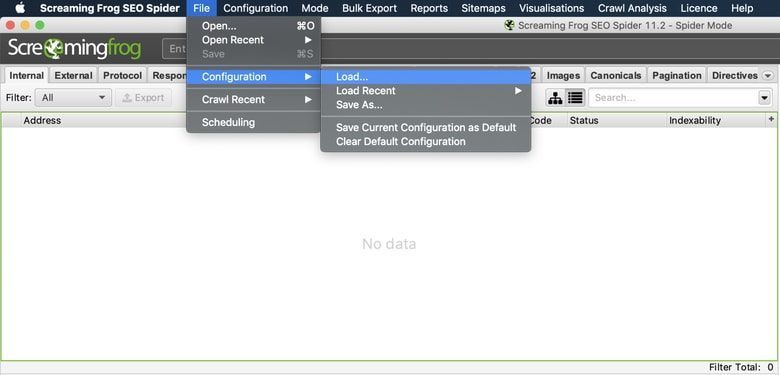
Now that you have configured your settings for your initial crawl, you can save these settings for future crawls so you don't have to go through this process every time. Just load the settings you need before running each scan.
File> Settings> Save As ...
File> Settings> Load ...
Tracking your first site
Now that we've set up our system and made our settings, the only thing left to do is start crawling our site!
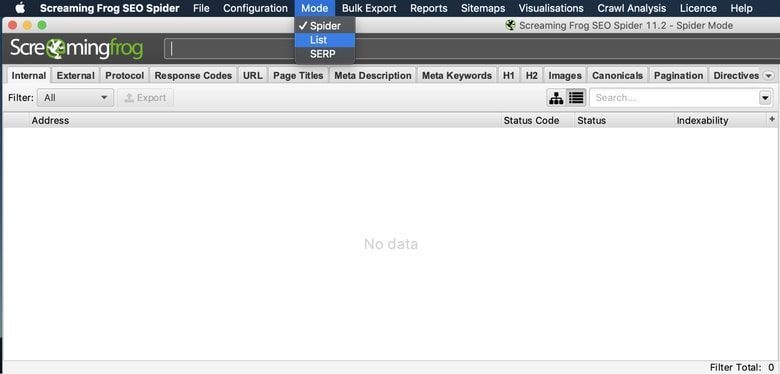
To crawl a website, you'll want to use Screaming Frogs' default "Spider" mode.
Mode> Spider> Enter URL> Click Start
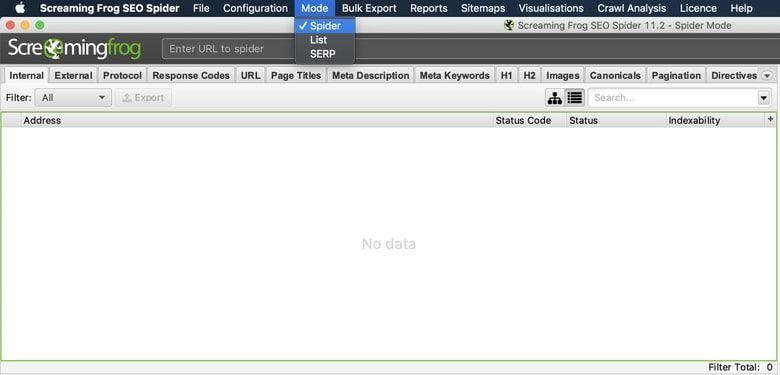

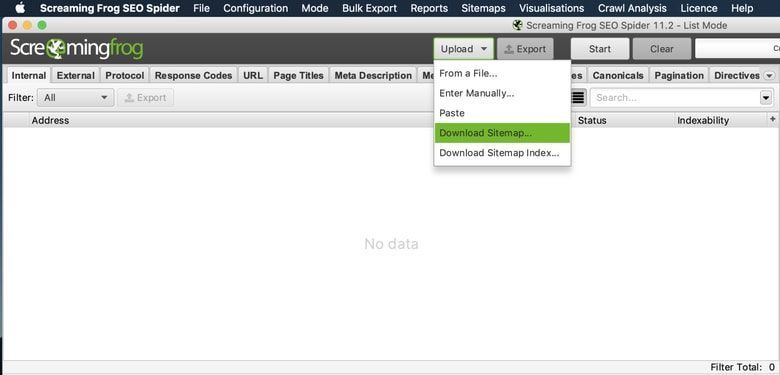
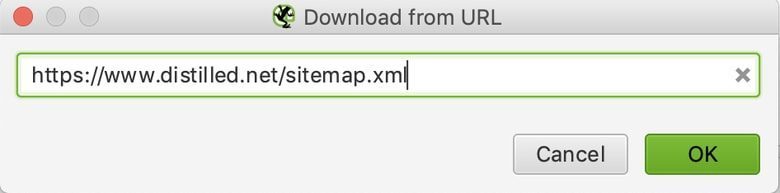
Además del modo Spider, también utilizo el modo «Lista» que rastreará una lista de URL que pueden provenir de un archivo o de una simple copia y pegado. Para este ejemplo, utilizaremos el sitemapUn sitemap o mapa del sitio es una representación estructurada de todas las páginas de una web. Tanto la estructura del sitio como los enlaces individuales entre las páginas pueden ser listados. Se pueden distinguir dos tipos de sitemaps distintos, HTML sitemaps y XML sitemaps. El sitemap HTML como árbol de navegación y vista general Los sitemaps HTML se pueden usar en las webs como una lista de todas las plus of a web.
Mode> List> Upload> Download sitemap
Important things to keep in mind when crawling:
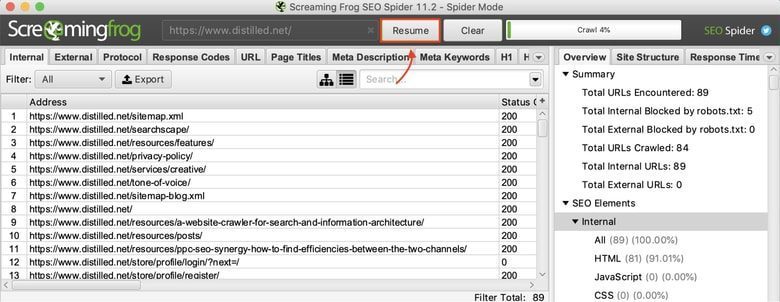
- You can stop and resume your crawl as needed.
- Shutting down the system or exiting Screaming Frog will cause your data to be lost.
- You can always save your tracking and resume to finish later.
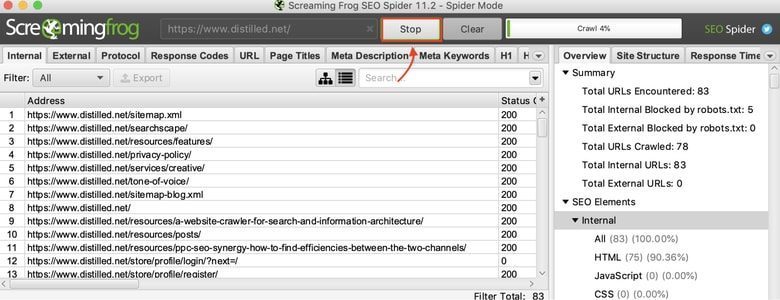
After crawling our site, it's time to use the data we've collected and give it some context.
If you'd like to share your first Screaming Frog experience, have any questions or comments, or found it helpful, please leave a comment below!