Si eres nuevo en la optimización de SuchmaschinenConcepto de Motores de Búsqueda¿Qué son los Motores de Búsqueda?Los Motores de búsqueda, o Search Engines, son lo que se conoce comúnmente como buscadores. Todos aquellos sistemas informáticos que trabajan buscando todos los archivos almacenados en internet por medio de de arañas o crawlers para elaborar páginas de resultados que sirvan para que los usuarios accedan a webs tras realizar una búsqueda. Son los responsables de que, al buscar cualquier Plus (SEO ¿Qué es SEO o search engine optimization? Conjunto de prácticas destinadas a mejorar el posicionamiento de una web en el ranking de resultados de los motores de búsqueda. Al contrario que la estrategia SEM, que contempla la inclusión de enlaces contratados para obtener este objetivo, el procedimiento SEO se ocupa exclusivamente de los resultados naturales (no pagados) localizados por el algoritmo propio de cada buscador. Para esto contempla ajustar Plus) o te encuentras por primera vez con Schreiender Frosch , Dieser Beitrag ist für Sie!
Beim Versuch, ein Gleichgewicht zwischen dem Erlernen neuer SEO-Konzepte zu finden als Teilzeitpraktikant und machen Sie sich mit den Tools vertraut, die wir täglich verwenden, Bekanntlich hatten wir weniger Zeit, um mit den Konzepten zu interagieren .
Mi primer rastreo como pasante fue para un sitio con más de cientos de miles de UrlEl URL (Localizador Uniforme de Recursos), es una dirección definida que apunta a la posición de un archivo en un servidor y lo recupera. Las URL se introducen en un navegador web para ingresar a documentos en la web o se incrustan como hipervínculos dentro de un documento. Se puede usar un Permalink para que una URL esté disponible de forma permanente. Componentes de una URL • prefijo de protocolo Plus y me encontré con un puñado de problemas de los que tuve que aprender. Cuando comience a trabajar en SEO, encontrará herramientas poderosas que lo ayudarán a encontrar datos valiosos. Es ist wichtig, diese Tools so effizient wie möglich verwenden und navigieren zu können.
En R Marketing Digital, una herramienta que usamos a menudo se llama Schreiender FroschConcepto de Screaming Frog¿Qué es Screaming Frog?Screaming Frog es una herramienta con la que están familiarizados los profesionales del posicionamiento. Consiste en un software dedicado al SEO que permite repasar una web por completo para detectar qué hace bien y qué hace mal al momento de obtener el mejor posicionamiento factible en buscadores web.Este programa rastrea toda la web como las arañas de los motores de búsqueda para, posteriormente, dar Plus, un rastreador de sitios web que rastrea URL y devuelve datos valiosos para que los analicemos para auditar el Technische SEOEl SEO técnico es una parte del SEO, que se centra en las posibilidades de optimización técnica de una web. Éstas incluyen, por ejemplo, el código fuente, los sistemas operativos y las configuraciones de servidor. El SEO técnico nunca es el único responsable de un buen posicionamiento de las palabras clave, sino más bien un prerrequisito para futuras acciones de optimización. Antecedentes Cuando Internet se convirtió en un éxito cada Plus y en el sitio.
In diesem BlogEl término blog se usa para describir un diario virtual en Internet. El autor de un blogger puede publicar posts sobre cualquier tema. Los posts suelen estar presente de forma cronológica. El estilo de redacción de un blog suele ser informal y se escribe en primera persona. No obstante, además son posibles otros estilos, por ejemplo en el caso de los periódicos online, en los que la atención se centra Plus, cubriremos cómo configurar su dispositivo para Screaming Frog y las configuraciones que se realizarán para rastrear un sitio y ejecutar su rastreo.
Einrichten Ihres Geräts
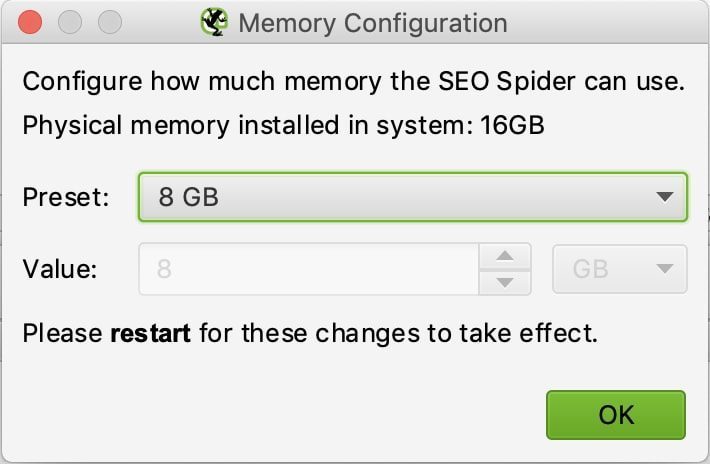
Wenn Sie mit dem Crawlen von Websites beginnen, werden Sie feststellen, dass einige Websites größer als andere sind und mehr Speicher von Ihrem System benötigen, um die gefundenen Daten von Screaming Frog zu speichern und zu verarbeiten. Bevor Sie mit dem Crawlen von Websites beginnen, sollten Sie Screaming Frog mehr RAM von Ihrem System zuweisen, um mehr Geschwindigkeit und Flexibilität für alle zukünftigen Crawls zu ermöglichen. Dies ist erforderlich, damit Websites mit mehr als 150.000 URLs gecrawlt werden können.
Konfiguration> System> Speicher
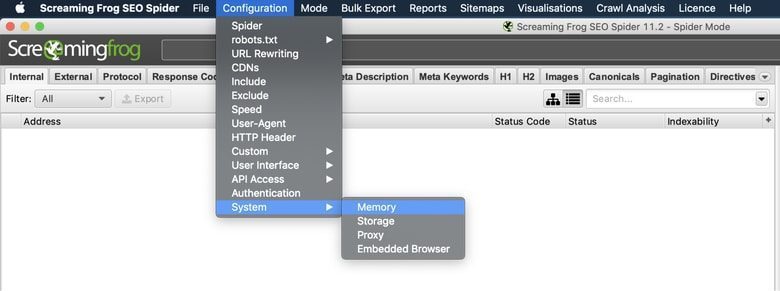
Die Standardeinstellung für 32-Bit-Computer ist 1 GB RAM und 2 GB RAM für 64-Bit-Computer. Ich empfehle die Verwendung von 8 GB, wodurch Screaming Frog bis zu 5 Millionen URLs crawlen kann. Screaming Frog empfiehlt, 2 GB weniger als Ihren gesamten RAM zu verwenden. Seien Sie jedoch vorsichtig, wenn Sie den gesamten RAM reservieren, kann es zu einem Absturz Ihres Systems kommen.
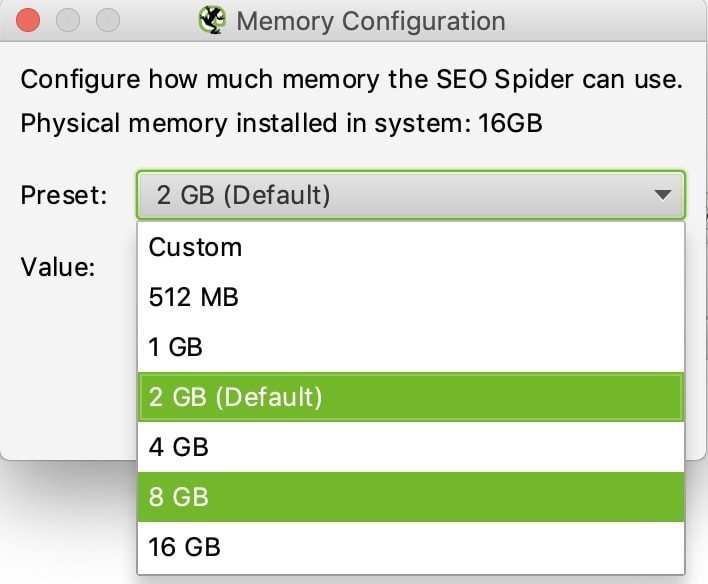
Cuando haya terminado de asignar más RAM a Screaming Frog, deberá reiniciar su SoftwareConcepto de Software¿Qué es el Software y cuál es su función?Un Software es la parte lógica, o más bien el soporte lógico, de cualquier sistema de tipo informático. Sea un PC, un teléfono teléfono celular o inclusive una tablet, es todo aquel programa que se ejecuta en él gracias a la coordinación de la parte física, es decir, el hardware, para llevar adelante alguna tarea concretamente o un recopilatorio de Plus para que se apliquen los cambios.
Konfigurationen
Sobald Sie mit dem Crawlen von Websites beginnen, müssen Sie Ihre Einstellungen entsprechend anpassen, um sicherzustellen, dass Screaming Frog so effizient wie möglich crawlt. Hier zeige ich Ihnen einige Grundeinstellungen, die ich gerne benutze.
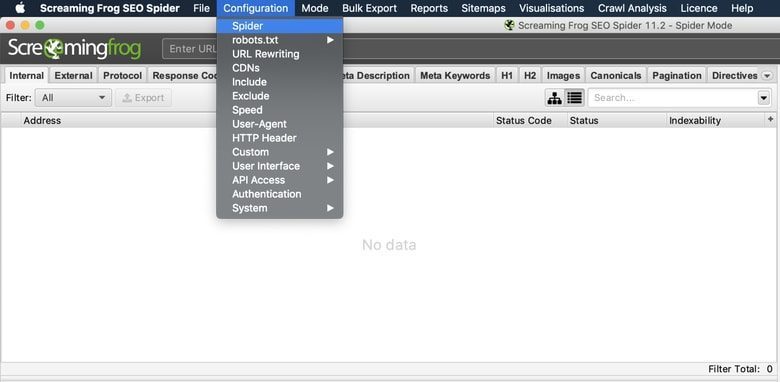
Einstellungen> Spider> Basic
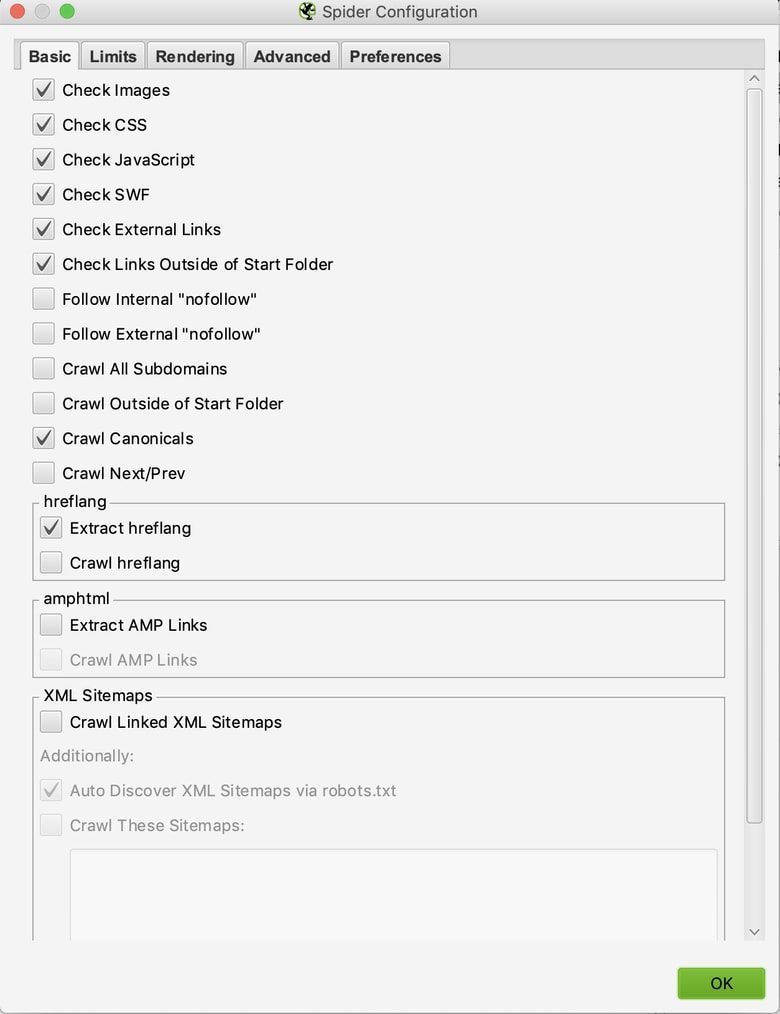
Dies sind die Standardeinstellungen, die Screaming Frog für jeden Crawl hat. Es ist eine gute Angewohnheit, Ihre spezifischen Einstellungen für den Crawl festzulegen, den Sie ausführen möchten, und hier Anpassungen vorzunehmen.
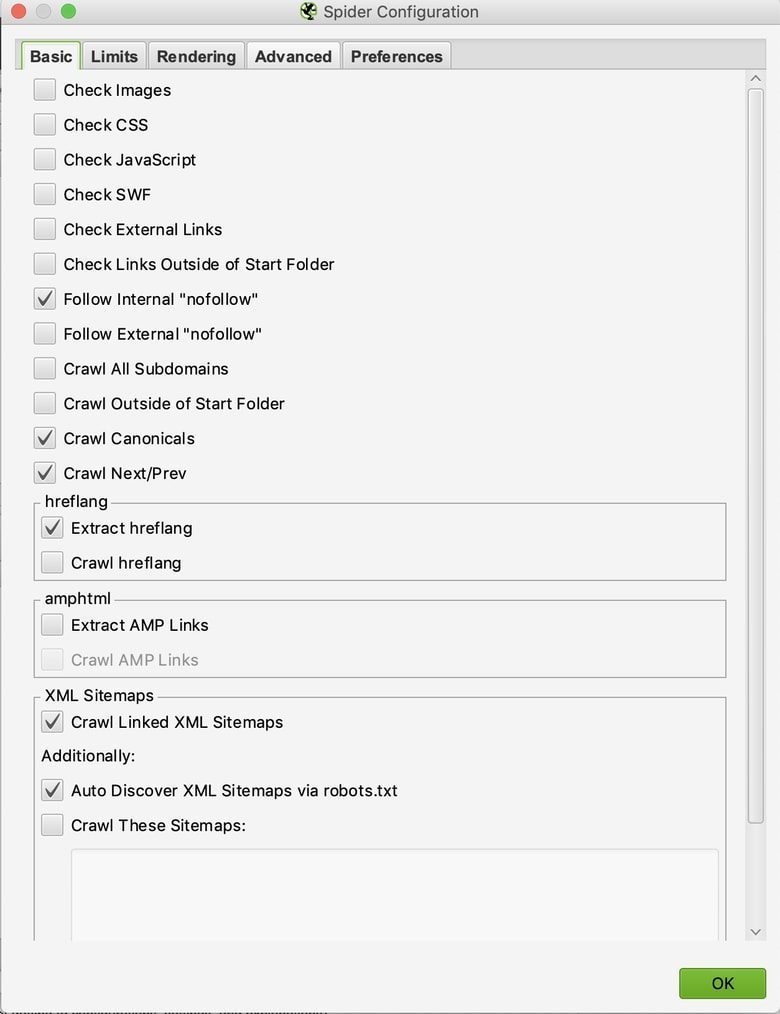
Dies sind die Grundeinstellungen, die ich hier bei R Marketing verwende, um meine technischen Audits durchzuführen:
- Folgen Sie " nicht folgen ”Intern : nos permite rastrear enlaces internosUn link entrante interno apunta a una subpágina dentro de una web, transfiriendo así el poder del link (el llamado "Enlace Juice") a la subpágina. A la vez, los enlaces internos además pasan al PageRank (además llamado flujo de rango de página). Una página obtiene este poder de link de enlaces entrantes externos. Es la página de inicio que tiene el mayor poder de link en la mayoría de los Plus con “atributos nicht folgenEl atributo rel="nofollow" es una microetiqueta en el código HTML de una web. Se usa para etiquetar hipervínculos por lo que no se tiene en cuenta en el índice de Google. Por lo tanto le dice a los robots de los motores de búsqueda que no se les permite seguir los enlaces mientras crawlean o rastrean el sitio. Información general Google introdujo el atributo rel=nofollow- en 2005 y otros motores Plus” para verificar si nuestro sitio está implementando esta etiqueta para mostrar InhaltEl contenido puede ser muy difícil de definir con precisión. Es una definición que se refiere a las declaraciones contenidas en un documento o publicación de cualquier tipo y puede incluir las tecnologías de la información y la comunicación. Esto cubre todos los tipos de medios como imágenes y texto. A parte de esto, en el campo de la optimización de motores de búsqueda, los términos duplicar contenido, contenido único, Plus que queremos / no queremos descubrir o indexar.
- Verfolgen Canonicals : ermöglicht es uns, kanonische Linkelemente zu verfolgen, um zu überprüfen, ob wir angeben, welche Seiten wir klassifizieren möchten.
- Verfolgen nächste / vorherige : Ermöglicht es uns, die Elemente rel = «next» und rel = «prev» zu verfolgen, um eine Vorstellung davon zu erhalten, ob unsere Site die Beziehung zwischen den Seiten klar kommuniziert.
- Auszug hreflang : muestra el idioma hreflangHreflang es un atributo que informa a Google y a otros motores de búsqueda sobre las distintos versiones lingüísticas de una página web. El contenido de la web se entregará para que coincida con la región de destino del usuario. La correcta implementación del atributo hreflang puede ser, de esta manera, beneficiosa para la usabilidad e indirectamente beneficiosa para el SEO. Contexto Con la creciente internacionalización de los sitios web, Google introdujo Plus, los códigos de región y la URL para verificar que estamos comunicando las diferentes variaciones de nuestro sitio.
- Verfolgen Sitemaps XMLEl lenguaje de marcado XML es menos complicado que su nombre ("Extensible Markup Language") puede hacer creer: Un archivo XML contiene texto altamente estructurado, semejante a los archivos HTML. No obstante, la estructuración del texto es tan clara y lógica que puede utilizarse para mapear bases de datos enteras. XML se usa frecuentemente para sitemap que se pueden cargar en la Google Search Console o en las Herramientas para Webmasters Plus vinculados : ermöglicht es uns, URLs in zu entdecken Sitemaps XML.
- Automatische Erkennung von XML-Sitemaps über robots.txt : ermöglicht es uns zu finden Sitemaps detectables a través de robots.txtEl archivo robots.txt es un documento que establece qué partes de un dominio pueden ser analizadas por los rastreadores de los motores de búsqueda y proporciona un link al XML-sitemap. Estructura El llamado “Robots Exclusion Standard Protocol“, Protocolo Estándar de Exclusiones Robots, se publicó por primera vez en 1994. Este protocolo define que los rastreadores de los motores de búsqueda deben buscar y leer el archivo llamado “robots.txt“ antes de Plus
Si está tratando con un sitio que utiliza JavaScriptJavaScript es un lenguaje de programación que funciona en el lado del cliente y con el que las webs pueden ser más funcionales. Incorporación en código HTML El código JavaScript puede ser incrustado en las páginas HTML, para que adquieran funcionalidad. Existen varias opciones. Puede estar entre las etiquetas <SCRIPT> y </SCRIPT>, puede estar contenido en un archivo externo, puede ser un parámetro de las etiquetas HTML, y puede estar Plus y desea verificar la navegación interna, deberá ejecutar un rastreo por separado con diferentes configuraciones para esa página específica, no todo el DomainUn dominio es una sección de Internet con direcciones que comparten un sufijo común o están bajo el control de una organización o individuo en particular. Está organizado jerárquicamente. Tanto los objetos físicos como los virtuales pueden ser direccionados con el nombre de dominio. Estos objetos pueden ser webs, ordenadores en red o servicios, como impresoras, faxes o servidores de correo. Cada objeto está referenciado por una dirección IP única, Plus. Navegue a la pestaña «representación» para asegurarse de que nuestro rastreador pueda encontrar esas instancias.
Einstellungen> Spider> Basic> Gerendert
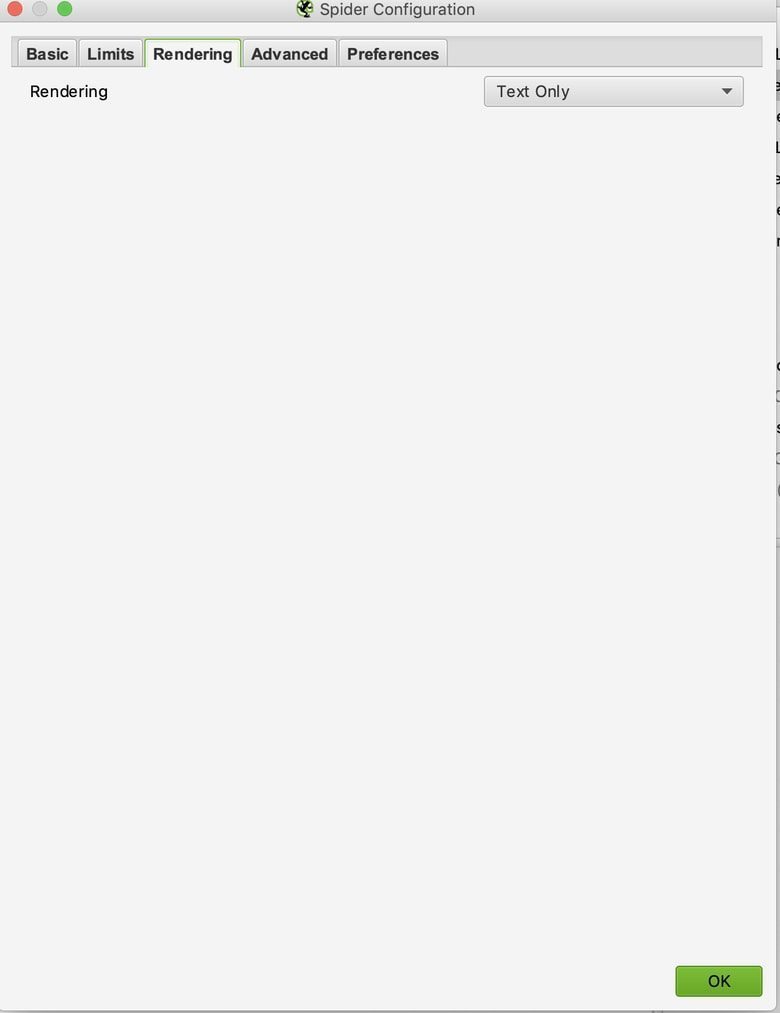
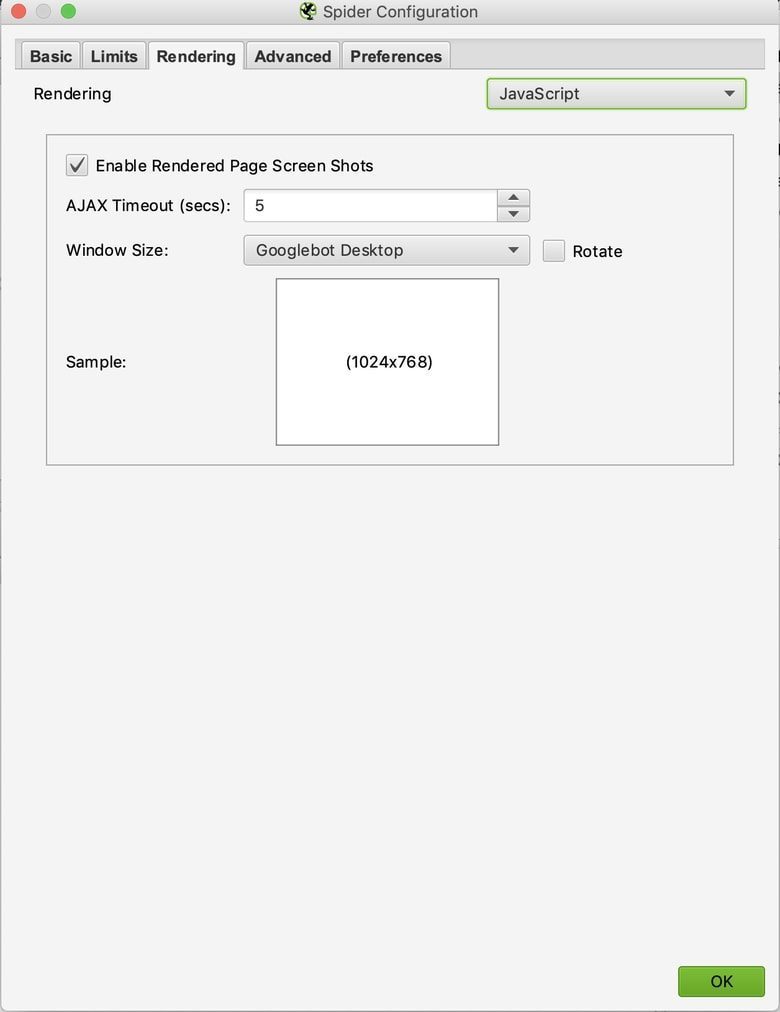
Después de las configuraciones de araña, siempre necesitamos establecer FilterConcepto de Filtros¿Qué son los Filtros?Los Filtros son unos mecanismos que, sea en el campo de la informática o en el de las páginas web, se usan para establecer qué tipo de contenidos se deben visualizar o mostrar por pantalla, o cuáles no deben aparecer. Es algo que se emplea en numerosos lugares con fines muy distintos, pero que siempre tiene como objetivo perfilar la búsqueda para acertar mejor con Plus personalizados para cosas específicas que queremos mostrar en nuestro rastreo.
Einstellungen> Benutzerdefiniert> Suchen
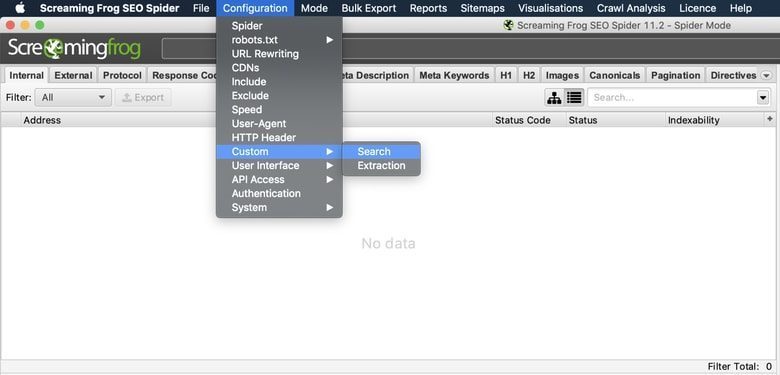
Ich verwende diese Filter regelmäßig, um Dinge einzuschließen und auszuschließen, die ich im Auge behalten möchte, und um sicherzustellen, dass alle Seiten berücksichtigt werden:
- <incrustar: comprueba cualquier contenido crucial cargado en flash
- <iframeConcepto de Iframe¿Qué es un Iframe?Un Iframe es un documento de una web que se inserta en otra página web. Consiste en un elemento que puede albergar cualquier tipo de contenido en su interior y que ayuda, entre otras cosas, a ampliar el mensaje que se ofrece con fuentes externas o con material complementario que pueda resultar de interés para el usuario que entra.Este elemento web se usa especialmente al Plus: comprueba cualquier contenido cargado en iframe
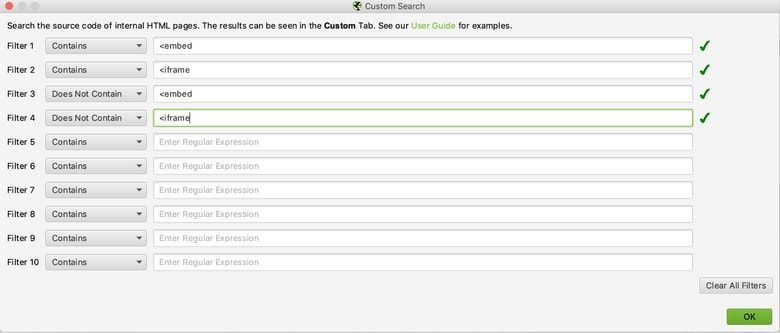
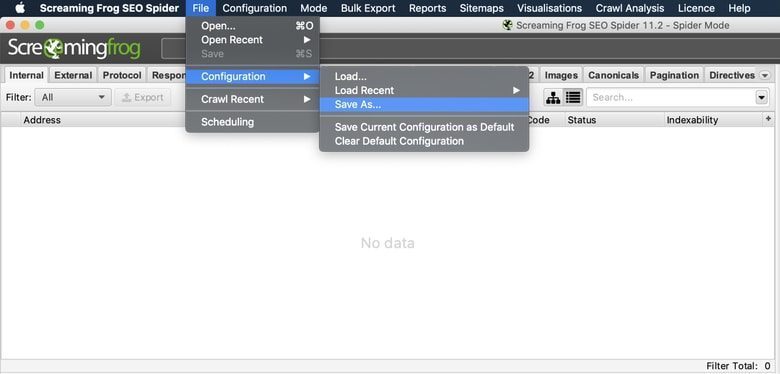
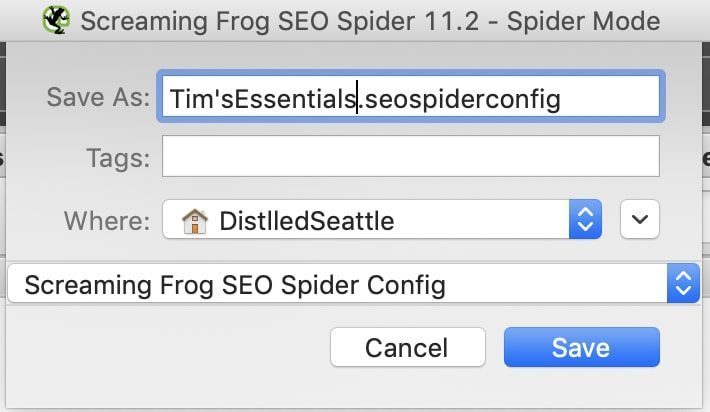
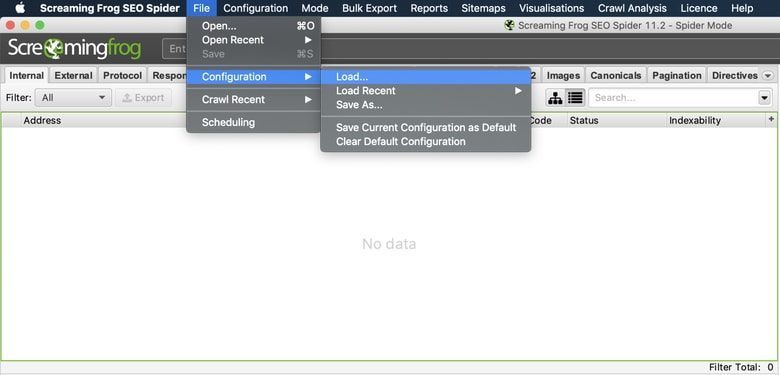
Nachdem Sie Ihre Einstellungen für das erste Crawlen konfiguriert haben, können Sie diese Einstellungen für zukünftige Crawls speichern, damit Sie diesen Vorgang nicht jedes Mal ausführen müssen. Laden Sie einfach die Einstellungen, die Sie benötigen, bevor Sie jeden Crawl ausführen.
Datei> Einstellungen> Speichern unter ...
Datei> Einstellungen> Laden ...
Verfolgen Sie Ihre erste Site
Nachdem wir unser System konfiguriert und unsere Konfigurationen vorgenommen haben, müssen wir nur noch mit dem Crawlen unserer Website beginnen!
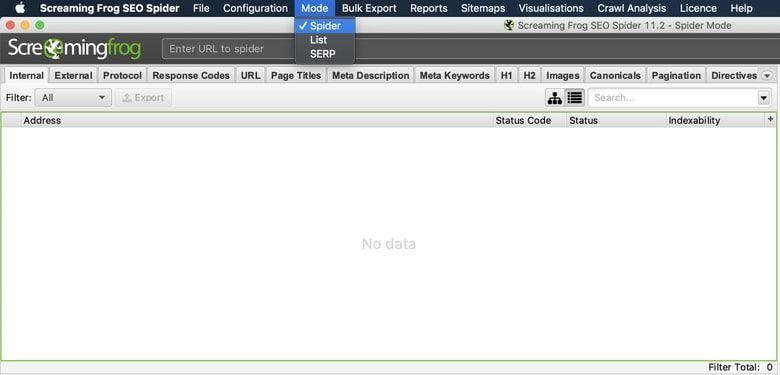
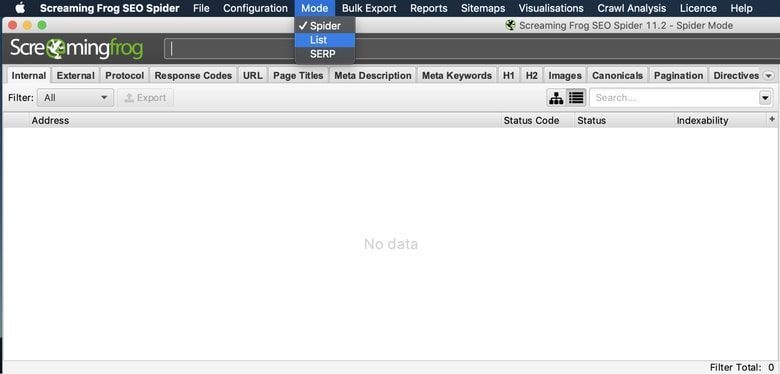
Um eine Website zu crawlen, sollten Sie den Standardmodus "Spider" von Screaming Frogs verwenden.
Modus> Spinne> URL eingeben> Klicken Sie auf Start

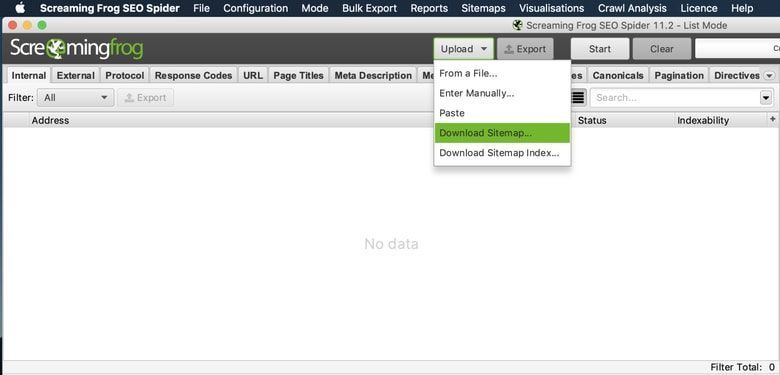
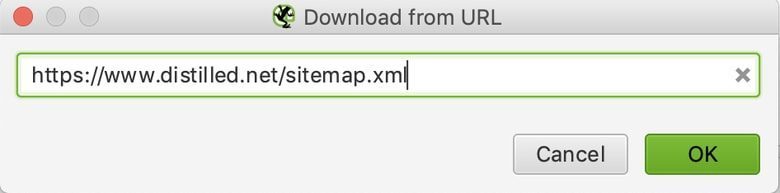
Además del modo Spider, también utilizo el modo «Lista» que rastreará una lista de URL que pueden provenir de un archivo o de una simple copia y pegado. Para este ejemplo, utilizaremos el SeitenverzeichnisUn sitemap o mapa del sitio es una representación estructurada de todas las páginas de una web. Tanto la estructura del sitio como los enlaces individuales entre las páginas pueden ser listados. Se pueden distinguir dos tipos de sitemaps distintos, HTML sitemaps y XML sitemaps. El sitemap HTML como árbol de navegación y vista general Los sitemaps HTML se pueden usar en las webs como una lista de todas las Plus eines Web.
Modus> Liste> Hochladen> Sitemap herunterladen
Wichtige Dinge, die Sie beim Crawlen beachten sollten:
- Sie können den Scan nach Bedarf stoppen und fortsetzen.
- Wenn Sie das System ausschalten oder Screaming Frog beenden, gehen Ihre Daten verloren.
- Sie können Ihre Ablaufverfolgung jederzeit speichern und fortsetzen, um sie später zu beenden.
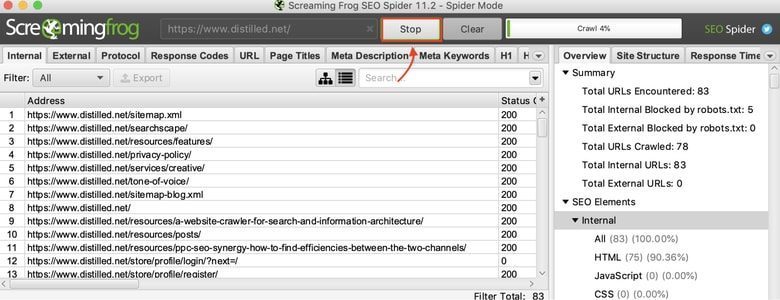
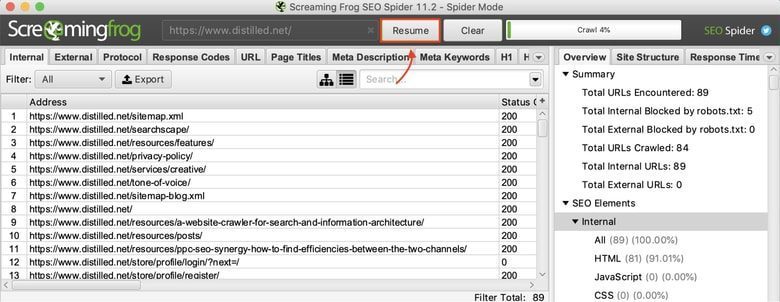
Nach dem Crawlen unserer Website ist es Zeit, die von uns gesammelten Daten zu verwenden und ihr einen kleinen Kontext zu geben.
Wenn Sie Ihre erste Erfahrung mit Screaming Frog teilen möchten, eine Frage oder einen Kommentar haben oder diese hilfreich fanden, hinterlassen Sie unten einen Kommentar!